Bayesianische Media-Mix-Modellierung
Ein Media-Mix-Modell schätzt den Umsatzbeitrag jedes Kanals und berücksichtigt Nachwirkung und Sättigung. Der bayesianische Ansatz legt Annahmen offen und liefert eine Spanne plausibler Ergebnisse.
8 Min. Lesezeit · Aktualisiert am 7. September 2026
Seitlich scrollen, um die ganze Abbildung zu sehen.
Was ist das?
Ein Media-Mix-Modell (MMM) erklärt eine Geschäftskennzahl, meist Umsatz oder Bestellungen, als Summe einer Basis und der Beiträge der Marketingkanäle im Zeitverlauf. Es nutzt aggregierte Daten: wöchentliche Kanalausgaben, Verkäufe und weitere Einflussgrößen wie Preise, Aktionen, Saisonalität oder Wettbewerb. Tracking einzelner Nutzer ist nicht erforderlich.
Bayesianisch ist das Modell, wenn jeder Parameter mit einem Prior beginnt: einer ausdrücklichen Annahme über seinen plausiblen Bereich. Die Daten aktualisieren ihn zum Posterior. Das Ergebnis ist eine Verteilung für die Wirkung jedes Kanals.
Warum ist das für die Mediaplanung wichtig?
Plattform-Dashboards berichten, was sie beobachten können. Attributionen überschneiden sich, und gesättigte Kanäle zeigen noch gute Durchschnitte, obwohl weitere Ausgaben kaum Ertrag bringen. Ein MMM betrachtet dieselben Wochen kanalübergreifend: Was änderte sich am Umsatz, als die Ausgaben eines Kanals stiegen, das andere Kanäle und der Kalender nicht bereits erklären?
Das ist die Frage hinter einer Budgetentscheidung. Das Modell liefert je Kanal eine Wirkungskurve. Aus „Dieser Kanal hat 4× ROAS“ wird: „Die nächsten 10.000 € bringen hier 0,9× und dort 3,1×.“
Wie funktioniert es?
Das Ergebnis wird in additive Teile zerlegt:
sales(t) = baseline
         + Σ over channels of  β × saturation( adstock( spend(t) ) )
         + seasonality(t) + trend(t) + controls(t) + noise
Drei Bausteine sind zentral.
Adstock trägt Wirkung in spätere Wochen. Beim üblichen geometrischen Adstock bleibt jede Woche ein fester Anteil erhalten.
Sättigung beschreibt, dass die zweite Million weniger bewirken kann als die erste. Häufig dient die Hill-Funktion mit Halbsättigungspunkt und Formparameter.
Der Koeffizient β skaliert die transformierten Ausgaben zu einem Umsatzbeitrag. Aus dessen Posterior und den Ausgaben lässt sich der inkrementelle Ertrag berechnen.
Priors bilden den bayesianischen Teil. Strukturelle Parameter wie die Adstock-Zerfallsrate erhalten bei gut bekannten Kanaleigenschaften starke Priors. Sättigungsparameter erhalten moderate, an typischen Ausgaben orientierte Priors. Kanalkoeffizienten erhalten schwächere, auf positive Werte beschränkte Priors, damit die Daten stärker wirken können. Ein möglicher Ausgangspunkt skaliert diese anhand des historischen Budgetanteils: Die bisherige Verteilung enthält bereits Annahmen des Unternehmens.
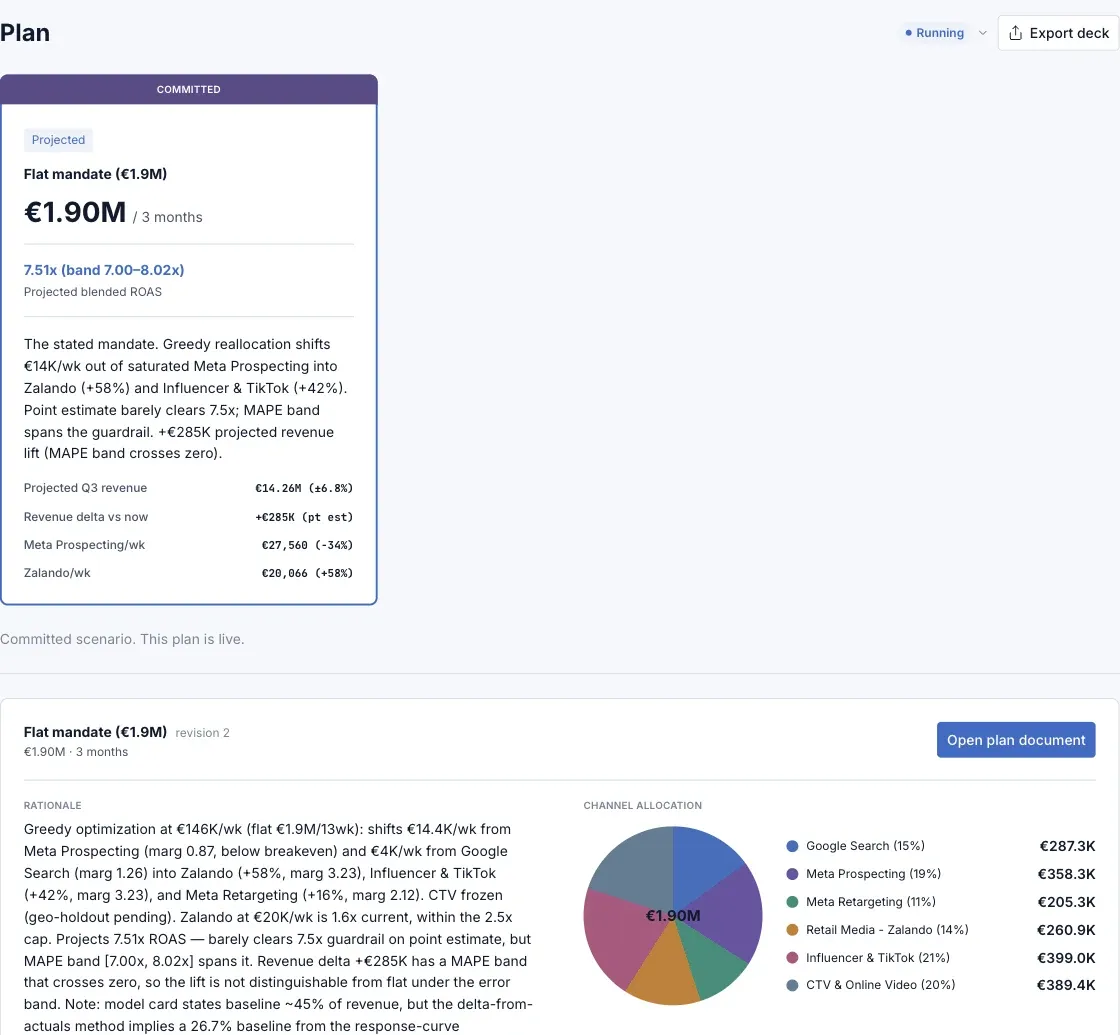
Die Anpassung erfolgt durch Markov-Chain-Monte-Carlo-Sampling. Es entstehen Posterior-Ziehungen für jeden Parameter. Wirkungskurven, Beiträge und Szenarioprognosen werden daraus berechnet. So entstehen die Spannen im Kuwalyst-Plan.
So nutzt Kuwalyst die Methode
Datenbasierte Pläne verwenden ein bayesianisches MMM auf dem Data Warehouse der Marke: Kanalausgaben, Umsatz, Bestellungen und Funnel, meist über zwei bis drei Jahre. Modelldokumentation, Priors, Kurven und Anpassungsdiagnostik sind als prüfbare Artefakte gespeichert.
Die Verteilung nutzt den marginalen inkrementellen ROAS beim aktuellen Budget. So kann Geld aus gesättigten Kanälen in solche mit Spielraum fließen. Szenarien tragen die Posterior-Spanne. Schließt die Spanne eines zusätzlichen Effekts null ein, wird das ausdrücklich benannt.
Ist eine Spanne zu breit für eine Entscheidung, schlägt der Planner meist einen Geo-Lift-Test vor. Sein Messwert wird beim nächsten Fit zum Prior. Modellieren, testen und neu kalibrieren macht aus einer einmaligen Analyse einen laufenden Prozess.
Auch Modelle Ihres Teams oder eines Partners lassen sich als Artefakte laden. Der Planner setzt kein eigenes Modell voraus.
Worauf Sie achten sollten
Gute Vorhersage ist noch keine korrekte Zuordnung. Gemeinsam schwankende Kanäle – etwa im vierten Quartal – können falsch gewichtet werden. R² und Prognosefehler außerhalb der Stichprobe sind nötig, reichen aber nicht aus. Ein Lift-Test prüft die Wirkung.
Die Falle der Markensuche: Fernsehen löst Markensuchen aus, ein additives Modell schreibt Search den Verkauf zu. Abhilfe reicht von externer Evidenz bei der Umverteilung bis zur expliziten Modellierung der Markensuche als Vermittler. Der Plan sollte den gewählten Ansatz nennen.
Zu schwache Priors können bei kurzen Daten unplausible Ergebnisse und Samplingprobleme verursachen. Zu enge Priors verhindern, dass Daten etwas verändern. Eine Sensitivitätsanalyse mit sinnvoll variierten Priors prüft beides.
Ohne Variation keine belastbare Antwort: Bei einem wöchentlichen Variationskoeffizienten unter 0,1 ist ein Kanal kaum identifizierbar. Das Modell wird stark vom Prior geprägt. Das sollte offengelegt und experimentell geprüft werden.
Zeitlich variable Effekte brauchen lange Historien – als Richtwert fünf Jahre oder mehr – und begründete Strukturänderungen. Sonst sind feste Koeffizienten mit ehrlichen Spannen oft verlässlicher.
Wann ist die Methode ungeeignet?
Bei einem dominierenden Einzelkanal, weniger als zwei Jahren Historie, Korrelationen über 0,95 zwischen Kanälen oder einem völlig neuen Produkt ist ein MMM häufig nicht das richtige erste Werkzeug. Hier kommen Experimente zuerst und das Modell später.
Im Produkt ansehen