Le modèle de mix média bayésien
Un modèle de mix média estime la contribution de chaque canal aux ventes en tenant compte de la rémanence et de la saturation. Une approche bayésienne rend les hypothèses initiales explicites et fournit une fourchette de résultats plausibles plutôt qu'une estimation unique.
8 min de lecture · Mis à jour 7 septembre 2026
Ce que c’est
Un modèle de mix média, ou MMM, est un modèle statistique qui explique un résultat d’entreprise, en général le chiffre d’affaires ou les commandes, comme la somme d’une base et de la contribution de chaque canal marketing dans le temps. Il travaille sur des données agrégées : dépense hebdomadaire par canal, ventes hebdomadaires, plus ce qui fait aussi bouger les ventes, comme le prix, les promotions, la saisonnalité et les concurrents. Il n’a pas besoin de suivi individuel, et c’est pour cela qu’il a survécu à la fin des cookies tiers.
Le modèle est bayésien quand chaque paramètre part d’un prior, une croyance énoncée sur sa plage plausible, et que les données transforment cette croyance en posterior. Le résultat est une distribution pour l’effet de chaque canal.
Pourquoi c’est important pour un plan média
Les dashboards des plateformes rapportent ce qu’ils voient. L’attribution se recoupe entre canaux, et un canal saturé continue d’afficher un bon retour moyen bien après que le prochain euro a cessé de le gagner. Un modèle de mix média regarde les mêmes semaines de l’extérieur et pose une autre question : quand la dépense sur ce canal a augmenté, qu’est-il arrivé aux ventes que les autres canaux et le calendrier n’expliquent pas déjà ?
C’est la question dont une décision budgétaire a besoin. La réponse du modèle est une courbe de réponse par canal, et cette courbe transforme « ce canal a un ROAS de 4× » en « les 10 000 € suivants sur ce canal rapportent 0,9×, et sur celui-là 3,1× ».
Comment ça marche
Tout MMM décompose le résultat en parties additives :
ventes(t) = base
          + Σ sur les canaux de  β × saturation( adstock( dépense(t) ) )
          + saisonnalité(t) + tendance(t) + contrôles(t) + bruit
Trois pièces font le travail.
L’adstock reporte la dépense d’une semaine sur les suivantes, parce que la publicité continue d’agir après sa diffusion. La forme habituelle est l’adstock géométrique : chaque semaine, une part fixe de l’effet de la semaine précédente subsiste.
La saturation courbe l’effet, parce que le deuxième million fait moins que le premier. La forme habituelle est la fonction de Hill : une courbe avec un point de demi-saturation et une forme.
Le coefficient β convertit la dépense transformée en chiffre d’affaires. Son posterior, divisé par la dépense, est le retour incrémental du canal.
La partie bayésienne, ce sont les priors. Un modèle bien construit en utilise trois niveaux. Les paramètres structurels comme la décroissance de l’adstock reçoivent des priors forts, parce que la physique des médias est bien connue : le search décroît en jours, la télévision en semaines. La saturation reçoit des priors modérés, liés à la dépense typique du canal. Les coefficients de canal reçoivent des priors faibles, pour laisser parler les données, contraints à rester positifs. Une bonne valeur par défaut pour les coefficients consiste à dimensionner leur prior selon la part du canal dans le budget historique : l’allocation de l’entreprise encode déjà ce qu’elle croit.
L’ajustement se fait par échantillonnage de Monte-Carlo par chaînes de Markov. Le résultat est un ensemble de tirages du posterior pour chaque paramètre, et tout ce qui suit, courbes de réponse, contributions, projections de scénarios, est calculé sur ces tirages. C’est de là que viennent les marges sur un plan Kuwalyst.
Comment Kuwalyst l’utilise
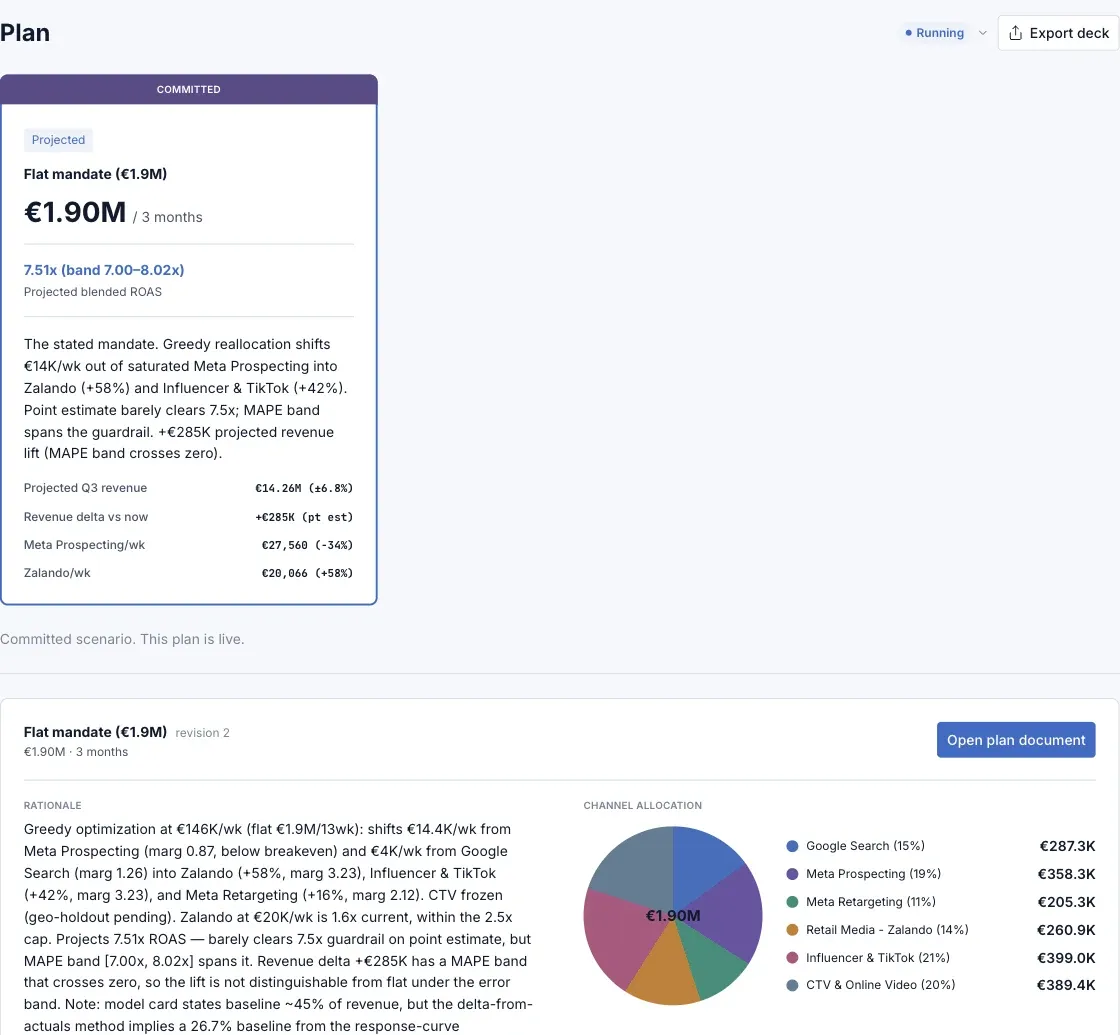
Le Media Planner fait tourner les plans fondés sur les données sur un MMM bayésien ajusté à l’entrepôt de la marque : dépense hebdomadaire par canal, chiffre d’affaires, commandes et funnel, en général deux à trois ans d’historique. La fiche du modèle, les priors, les courbes de réponse et les diagnostics d’ajustement sont conservés comme des artefacts que l’équipe peut inspecter.
L’allocation n’utilise jamais le ROAS moyen. Elle utilise le ROAS incrémental marginal lu sur la courbe de réponse de chaque canal à sa dépense actuelle, pour que le budget passe des canaux saturés vers les canaux qui ont de la marge. Les projections de scénarios portent la fourchette du posterior, et le plan dit quand cette fourchette traverse zéro : un gain projeté qu’on ne peut pas distinguer de zéro est rapporté comme tel.
Quand la fourchette d’un canal est trop large pour décider, le planner propose l’expérience qui la resserrerait, en général un test geo-lift. Le résultat mesuré devient un prior dans l’ajustement suivant. Cette boucle, modéliser, tester, recalibrer, fait la différence entre un modèle construit une fois et un modèle qui continue de mériter sa place.
Les modèles déjà construits par votre équipe ou un partenaire peuvent aussi être chargés comme artefacts. Le planner n’impose pas le sien.
Les pièges
Un bon ajustement n’est pas une bonne attribution : un modèle peut bien prédire les ventes et créditer le mauvais canal, parce que les canaux bougent ensemble : tout le monde dépense plus au quatrième trimestre. Le R² et l’erreur hors échantillon sont nécessaires, pas suffisants. Le test de l’attribution, c’est un lift test.
Le piège du search de marque : la télévision crée des recherches de marque ; un modèle additif crédite la vente au search. Les canaux du haut de funnel sont sous-crédités, ceux du bas surcrédités. Les remèdes vont de la réallocation à partir de preuves externes à la modélisation explicite du search de marque comme médiateur, et le plan doit dire lequel a été utilisé.
Priors plats, posteriors sauvages : sur des données courtes, des priors non informatifs produisent des retours invraisemblables et des problèmes d’échantillonnage. Des priors trop serrés font l’inverse : le posterior est le prior et les données n’ont jamais compté. La sensibilité aux priors, refaire l’ajustement avec des priors déplacés d’une quantité raisonnable, est le contrôle.
Pas de variation, pas de réponse : un canal dont le coefficient de variation de la dépense hebdomadaire est inférieur à 0,1 n’est pas identifiable à partir des données. Le modèle renverra son prior. Il faut le dire, et tester à la place.
Des effets variables dans le temps sur des données courtes : laisser dériver les coefficients demande cinq ans ou plus et un changement de régime documenté. Sinon, des coefficients fixes avec des marges honnêtes sont plus fiables.
Quand ne pas l’utiliser
Un modèle de mix média est le mauvais outil avec un seul canal dominant, avec moins de deux ans d’historique, avec des canaux corrélés au-delà de 0,95, ou pour un produit tout nouveau. Dans chacun de ces cas, les expériences viennent d’abord et le modèle ensuite.
Le voir dans le produit